[译]Sentry:如何从数据存储中获得更强的一致性
翻译自:How to Get Stronger Consistency Out of a Datastore
地址:https://blog.sentry.io/2019/09/17/how-to-get-stronger-consistency-out-of-a-datastore
原文发表于2019年,描述的是Sentry当时的ClickHouse配置和架构,不是所有ClickHouse部署的默认行为。特别是下文的写入确认、副本选择及同步Distributed写入,都需结合版本和设置阅读。
欢迎来到我们的系列博文,这里记录的都是 Sentry 做过的一些“也许不该做”的事。别误会——我们并不后悔这些决定。分享这些笔记,是因为万一你也选择了这条少有人走的路,或许用得上。在本文中,我们把技术推到极限,以便在应对流量高峰的同时看到实时数据。(对 Apache Kafka 和分布式系统一致性模型有基本了解,会有助于读懂本文。)
Sentry 的首要工作是接收用户的错误信息。当用户异常信息大量上报时,Sentry的流量将达到高峰。同时,提供近实时的错误追踪,对于用户是有帮助的。
这里有两个可能相互冲突的需求:
- 事件(Event)摄入服务必须在各种负载的情况下都具有响应快速且可伸缩的能力。
- Sentry用户必须近实时地可以看到异常信息。
为了能够应对流量高峰,Sentry从客户端接收事件,并异步执行一系列处理。 因此,这些处理不一定在客户端收到 HTTP 响应之前完成。
其中两个阶段包括在 Sentry 主存储(ClickHouse)上保存事件和发送通知、调用插件等的后处理任务(post process task)。
下文中的后处理指的都是post process
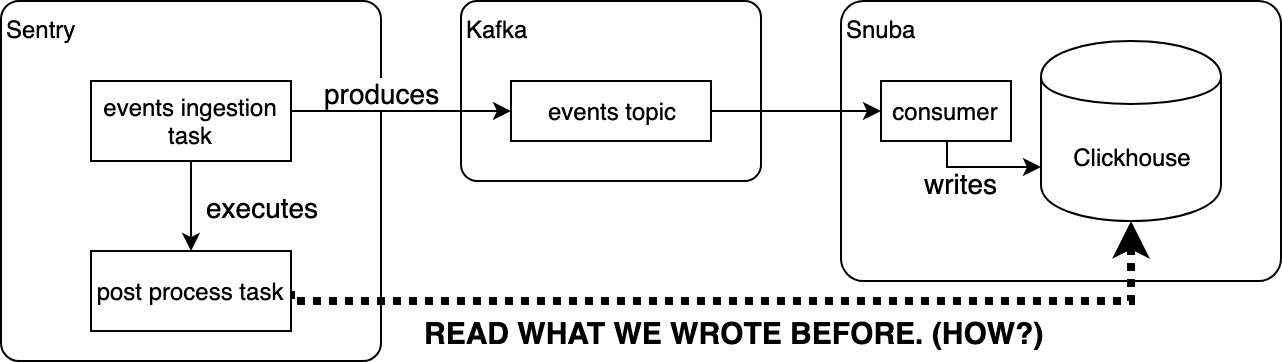
为了将事件保存到 ClickHouse,我们先把事件插入 Kafka 主题中。一些消费者从该主题中读取并以批量插入的方式写入到ClickHouse中。
在保存了事件之后,我们触发了上面讨论的后处理任务,它需要从ClickHouse读取最新的事件(比如历史数据和我们刚刚处理的事件)才能正常工作。
且慢。“事件保存后?”。在尝试读取事件之前,我们如何确定该事件已被保存到ClickHouse中?好吧,我们不能完全确定。最后,事件摄入任务只是将事件保存到Kafka主题中。
为了确保读取前事件已经写入,原文提出需要顺序一致性(假设事件摄入和后处理在不同进程中),或在两者属于同一进程时提供读己之写(read-your-writes)一致性。(有关一致性模型的更多信息。)
如果一个存储系统的写操作是异步发生的,而读操作与写操作过程不是同步的,那么这个存储系统就不能提供任何一种这样的保证。因此,我们需要用不同的架构来缓解这个问题。
我们可以把这个问题分成两部分:
- 当后处理任务尝试读取时,事件可能根本没有到达ClickHouse。作为一种解决方案,后处理任务需要等待事件通过Kafka到达ClickHouse之后再进行。
- 即使等ClickHouse写入后再运行后处理,仍要考虑副本一致性。在这里的分布式、复制配置下,默认读取不保证读己之写;我们需要从已收到目标事件的副本读取。
写入ClickHouse后,触发后处理任务
解决这个问题相当于在运行后处理逻辑之前,等待某个主题中的某个 Kafka 消费者把该事件消费并提交。
对于这个问题,有下面几种解决办法:
- 使用分布式锁框架使后处理任务等待。虽然这可行,但它需要我们在架构中添加另一个分布式系统框架,从而增加复杂性。
- 在写入ClickHouse之后,让Snuba触发后处理任务。这个解决方案有一个重要的架构含义,Snuba将依赖于Sentry(而不是相反)。添加这种附加依赖关系不是我们所期望的。
- 使用Kafka
__consumer_offsets主题使后处理任务等待。该策略与我们构建的解决方案类似,问题主要在实践层面。例如,我们使用的Kafka库没有提供解码该主题消息的抽象。 - 将完整的事件传递给需要它的后处理任务,而不是从数据库中重新加载数据。我们实际上是这样做的。不幸的是,这还不够,因为后处理任务需要运行需要读到最新写入数据的聚合查询。
同步消费者(SynchronizedConsumer)
我们没有使用这四个解决方案,而是构建了一个系统,该系统允许Kafka消费者暂停自己并等待另一个消费者(在独立消费组上)提交偏移量,然后再使用相同的消息。
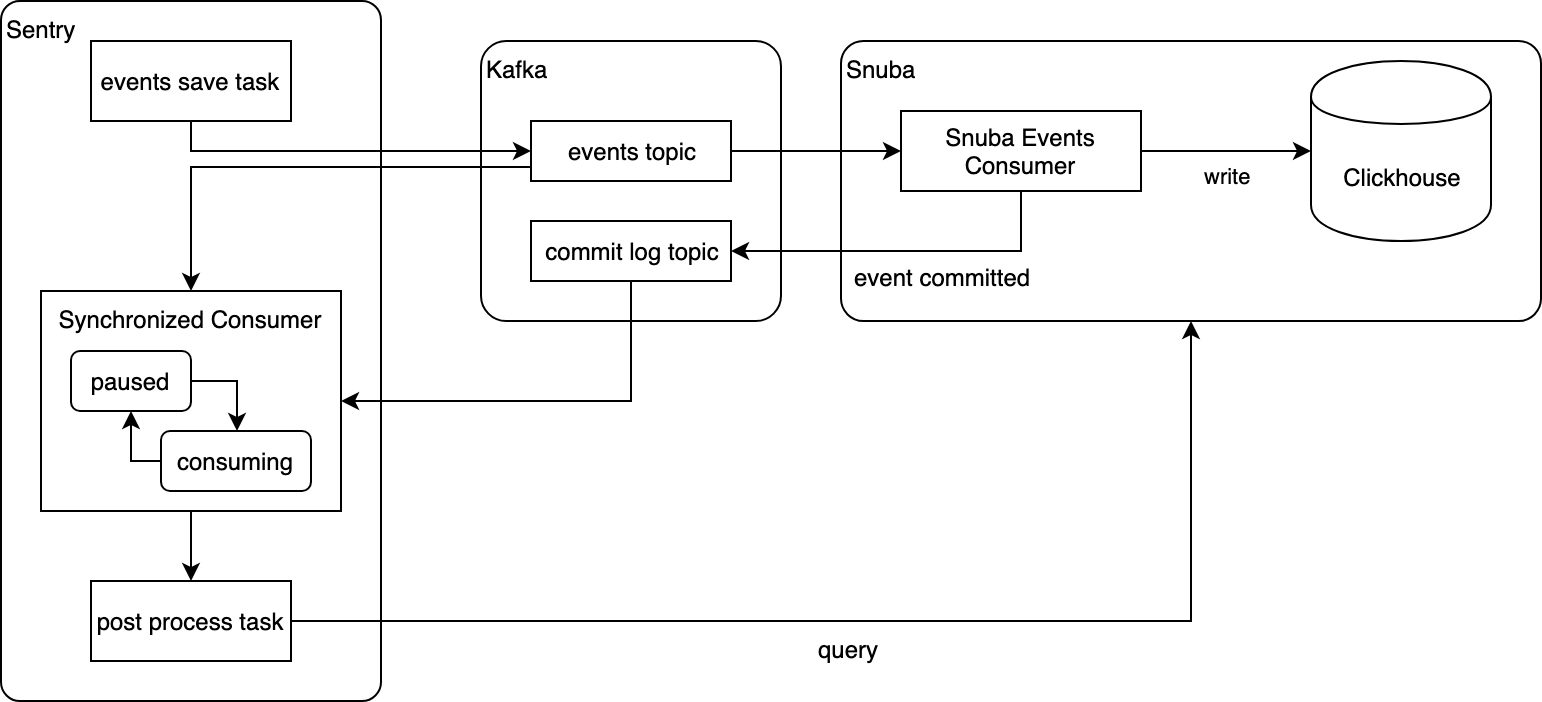
如上图所示,消费事件主题中的事件将触发后处理任务。我们希望只有当Snuba事件消费者将事件存储到ClickHouse时,后处理任务组件才能处理事件,以便后处理任务可以读取事件。
为此,我们让Snuba在事件写入ClickHouse后发出通告(advertise)。通告通过另一个Kafka主题(commit log topic,提交日志主题)传递,Snuba事件消费者在提交偏移量后向该主题写入消息。
以下代码段是有关提交日志主题的有效负载示例。消息的键通过提供主题,分区和组来标识事件主题。有效负载本身就是要提交的偏移量。
1 | key: events:0:snuba-consumers #topic:partition:group |
启动同步消费者时,需要从提交日志主题重新加载所有分区的状态(最后提交的偏移量)。为了使此过程快速进行,提交日志主题是一个日志压缩(compaction)主题,并且初始偏移量设置为最早的(最早的提交偏移量)。
由于我们仅在Kafka消息存储在ClickHouse中时才提交它们,因此这是我们需要的解决方案;它是由我们的批处理Kafka消费者执行的。
现在,我们在Kafka中有一个主题,它告诉我们通过Snuba Consumer从每个分区消费的偏移量是多少。因此,只有在消费者处理了偏移量后,我们才需要对事件进行后处理。
同步消费者处理协调。 该消费者同时读取事件主题和提交日志主题(在两个独立的线程上)。 它在内部运行状态机,该状态机跟踪提交日志中的最大偏移量,并仅从事件主题消费直到追上提交日志中的偏移(watermark)。
当同步消费者赶上分区的提交日志中的最新偏移量时,它将停止消费该分区中的事件,直到提交了更多事件为止。
这个解决方案是可行的,但是,作为这个问题的任何解决方案,在可用性方面都存在妥协。如果流的存储部分被延迟,读取就会被暂停,后处理任务也是如此。
确保ClickHouse在副本上复制了我们的事件
ClickHouse是一个分布式数据库,具有多主、最终一致的异步复制。这句话信息量很大,所以让我们来分析一下它与当前问题的关联:
- 分布式数据库→在这种情况下,“分布式数据库”意味着我们将表分区到多个节点上。当ClickHouse接收到一批要写入的行时,默认情况下,它将对这些行进行分区并异步地将它们发送到正确的分区。当写入端收到响应时,可能未将批处理写入所有分区。
- 复制是异步的,并且最终是一致的→读取可以发生在任何副本上,使用默认的负载平衡模式。在读取时,我们可能会遇到过时的数据,因为我们读取的副本可能未收到最新的写入数据。
- 多主复制→写可以发生在任何节点上,并且可能不会以相同的顺序应用在所有副本上。最后,合并处理确保所有副本上的数据是一致的。在写入一个节点和一个副本之后,ClickHouse返回(默认情况下)。因此,仅仅丢失我们写入的那个副本,并不足以造成数据丢失。
原文这段关于写入确认和单副本丢失的描述不能作为通用保证。确认前已写入多少份数据取决于表引擎、insert_quorum等设置;异步复制本身不保证确认时已有第二份副本。
即使我们在开始后处理之前等待Kafka提交(如上所述),我们仍然可以从ClickHouse副本中读到不是最新的数据;以上的解决方案仍然不够。
幸运的是,ClickHouse的灵活性更高,它使我们能够为每个查询提供更强的一致性保证,而不会损害不需要强一致性的查询的性能。
最初的想法是结合insert_quorum和select_sequential_consistency设置,这将保证给定数量的副本在返回之前收到更新。该组合设置可以保证我们查询的是最新的副本。
主要问题是select_sequential_consistency不能保证负载平衡器选择一个最新的副本。相反,只要存在任何一个尚未同步到所选副本的进行中写入,查询就会失败——这对我们不起作用。
因此,我们将问题一分为二,以探索不同的解决方案:
如何确保读取的副本是最新的?
当我们需要这种保证时(不是所有查询都需要),我们使用in_order负载均衡模式。该模式驱动负载均衡器按照配置中定义的顺序选择健康的副本。因此,只要第一个副本启动并运行,负载均衡器就会选择它。我们可以对读和写都这样做,本质上是对同一个副本进行读写,只要它运行状况良好。这个副本显然是最新的。
我们如何确保所有分区在读取前都已写入批处理?
在写入时,ClickHouse为我们提供了另一个方便的选项:insert_distributed_sync,它将分区设置为同步运行(而不是异步运行)。客户端只有在所有分区都收到写操作之后才会收到确认,这样就消除了读取器从非最新分区读取的风险。
顺序一致性
这两个解决方案产生了一个一致性模型,该模型表面上类似于顺序一致性。通过同一个节点进行读写,所有的写操作看起来都是按一个总的顺序进行的。客户端一旦读取了某个事件,之后就不会再读到比它更旧的状态。
我们是否打破了CAP定理?没有。
我们选择一致性并牺牲可用性了吗?不,我们仍然依赖可用性。只要所有副本都在运行,这就是系统提供的一致性模型(这意味着系统不保证此一致性模型)。如果我们在某个副本上写入,而该副本在我们读取之前宕机,则不能保证负载均衡器转到已经收到该写操作的副本。我们不能说我们保证顺序一致性或读己之写(read-your-writes)一致性,尽管这是我们经常达到的结果。
这是性能问题吗?在一定程度上是的。对同一个副本的读写显然会将存储性能绑定到该副本,但到目前为止,它已经足够好了。
并非所有读取都需要保持一致,因此查询时何时使用in_order负载平衡由客户端决定。这种解决方案允许在不过度降低性能的情况下实现足够好的一致性。
到目前为止,我们讨论了如何在大多数情况下从最终一致的数据库中获得更强的一致性。在另一个领域,我们尝试做一些ClickHouse不打算做的事情:在记录写入数据库后更新记录。ClickHouse最适合不可变数据,尽管 Sentry 在大多数情况下数据不可变,但确实有少数操作需要更新记录的能力。
我们是如何解决这个问题的?本系列的下一篇文章将分享我们如何最大限度地利用可变性!