[译]自上而下认识Elasticsearch:集群、节点与请求协调
原文发表于2014年。下文的type、djb2、write_consistency和query_and_fetch均属于当时的实现,不宜直接用于新版Elasticsearch。
原文地址:https://www.elastic.co/cn/blog/found-elasticsearch-top-down
Introduction
在上一篇文章”自下而上认识Elasticsearch:倒排索引、Segment 与事务”中,我们从相当底层的数据结构开始,然后提升到抽象层以将它们置于上下文中.然而,我们专注于单个分片内发生的事情.
要查看所有这些如何在分布式环境中组合在一起,从另一端开始更容易:从用户的角度观察,从”顶部”开始.
我们将看看当用户向Elasticsearch发送索引和搜索请求时会发生什么,以及这些请求如何在节点之间流转,直到我们到达前面介绍的较低级别的结构.首先,我们将查看接受请求的节点及其作为协调器的角色.我们将看看它如何把索引请求路由到各分片的主分片,以及如何在副本之间为搜索请求做负载均衡.
在被路由到正确的分片之后,我们将看看在分片级别发生了什么——例如什么构成了”成功”的索引操作,以及将文档和搜索转换为它们的Lucene等价物所需的转换.对于搜索请求,我们还将查看分散/聚集过程,这可能发生在多轮中.
A Cluster of Nodes
为了描述Elasticsearch的工作原理,我们需要某种集群拓扑.图中的集群描述了我们假设的集群类型.我们有一个带有两个分片的Elasticsearch索引,为了可用性在两个不同”区域”的数据节点之间进行复制;专用主节点(master-only节点)则分布在三个区域中.此外,我们有两个客户端节点,我们将通过它们发送请求.
集群中的不同节点可以具有不同的角色(data and/or master – or none as a client)以及属性(例如区域/zone).我们有数据节点、主节点和客户端节点——在不同的区域,即具有不同的 node.zone 属性.本文中我们关注数据节点.想了解其他类型的节点,推荐阅读《Elasticsearch in Production》和《Java Clients for Elasticsearch》.
Request Coordinators
当您向Elasticsearch中的节点发送请求时,该节点将成为该请求的协调器.它将决定将请求路由到哪些节点和分片,如何合并不同节点的响应,以及决定请求何时”完成”.虽然Elasticsearch会为您透明地处理这个问题,但高级分区方案需要有关内部处理和路由的知识.上述给定集群,客户端节点将充当协调器.
为了能够充当协调器,节点需要知道集群的状态.集群状态被复制到集群中的每个节点.它具有分片路由表(哪些节点托管哪些索引和分片)、关于每个节点的元数据(例如它运行的位置和节点具有的属性)以及索引映射(其中可以包含重要的路由配置)和模板.集群状态被复制到所有节点是映射需要合理大小的一个重要原因.
对于搜索请求,协调意味着选择分片的副本、发送请求以进行进一步处理,可能需要多轮处理,我们稍后将对此进行更多研究.选择副本是随机完成的,或者受请求偏好的影响.
索引请求(即创建、更新或删除文档的请求)略有不同.请求先路由到主分片,再由主分片复制到副本.旧版的write_consistency可以设为one、quorum或all,用于检查写入前有多少分片副本可用;默认是quorum,但配置的副本数少于2时只要求一个可用分片副本.
译者注:原文把write_consistency的可用性检查与复制完成的确认混在了一起。它不是“收到多数副本确认就返回”的开关。Elasticsearch 5.0起改用wait_for_active_shards,同样是在写入前检查活跃分片数,不代表这些副本已经成功写入。
Index a Document to an Index of … Indexes?
术语”索引”在很多上下文中使用,具有不同的含义.您将文档索引到Elasticsearch索引.Elasticsearch索引有分片,也就是 Lucene索引.那些有倒排索引.这可能会让人感到困惑.
一个重要的见解是,从概念上讲,具有两个分片的Elasticsearch索引与每个具有一个分片的两个Elasticsearch索引完全相同.最终,它们是两个Lucene索引.不同之处主要在于Elasticsearch通过其路由功能提供的便利性.仅使用单个分片索引就可以实现相同的”手动”.(不是你应该!)
重要的部分是通过分片的概念,认识到Elasticsearch索引是Lucene索引集合之上的抽象.当您需要考虑更高级的分区策略时,这会有所帮助.
Index Requests
索引请求是创建或更改索引中文档的请求.无论是新建文档、删除文档还是更新文档,都不是很重要,所以我们统称为”索引请求”.
考虑以下批量请求:
1 | { |
处理这个请求的节点需要考虑几个问题:
- tweets和logs的路由配置是什么?这可以通过查看集群状态中的映射来确定.对于tweets,可能存在基于用户的路由,因此tweets的user属性应确定将文档路由到哪个分片.我们将在下一节中查看一些示例.
- 在确定了两条tweets的分片之后,我们什么时候可以认为文档真正被索引了?由于未指定任何内容,因此默认为节点的默认 action.write_consistency,默认为quorum.
- logs消息没有与之关联的ID.所有文档都必须有一个,因此协调员必须为其分配一个.文档ID是协调器将用来路由请求的内容,如果操作或映射没有覆盖它的话.(然而,分配ID和具有幂等请求是最佳实践)
- logs操作指定了严格的_consistency设置,要求写入前所有配置的分片副本都可用.
- 什么时候可以整体完成批量请求?
Routing
路由指定哪些文档去哪里,因此是请求如何在Elasticsearch内部流动的重要部分,包括搜索和索引请求.它是设计适当的数据流和索引分区不可或缺的一部分.在这里,我们专注于机制,因为索引和分片设计是一个大话题.
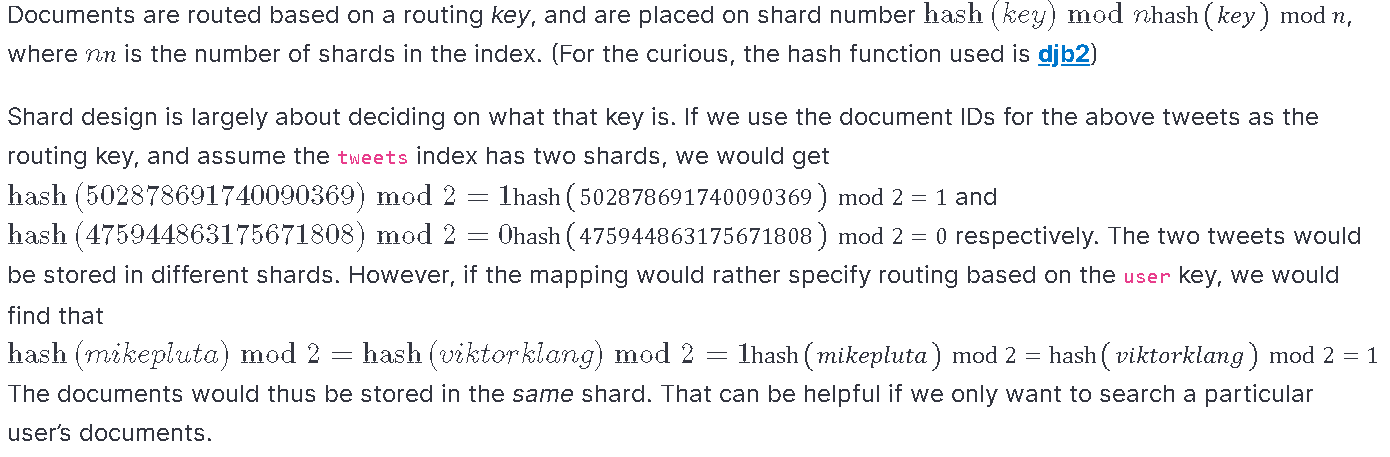
文档根据一个路由键(routing key)被路由,放置到编号为hash(key) mod n的分片上,其中n是索引中的分片数.(原文当时使用的哈希函数是djb2;新版已不同.)
分片设计在很大程度上就是决定这个key是什么.如果我们用上面两条tweets的文档ID作为路由键,并假设tweets索引有两个分片,那么会分别得到 hash(502878691740090369) mod 2 = 1 和 hash(475944863175671808) mod 2 = 0,这两条tweets会被存放在不同的分片.然而,如果映射改为基于user键路由,我们会发现 hash(mikepluta) mod 2 = hash(viktorklang) mod 2 = 1,这样两条文档就会被存放在同一个分片.如果我们只想搜索某个特定用户的文档,这就很有帮助.
Primary Concerns
当索引操作被路由时,它被转发到该分片的”主”.一个分片只有一个”主”,以及零个或多个副本.在这方面,primary可以被认为是分片的”master”,而replicas可以被认为是”slaves”.
该分片的主分片将充当这次索引操作的协调器.它会将索引操作发送到相关的副本,在同步复制路径上等待参与复制的副本处理完成.

复制处理完成后,主分片把结果报告给原始请求协调器,在我们的例子中是客户端节点.原文及上图把quorum解释为“三个操作中两个确认就可以返回”,这里应与前面的写入可用性检查区分开:quorum并不让同步复制忽略第三个参与复制的副本.副本失败的处理和最终响应中的成功数量,还取决于当时的复制实现.
协调器/客户端节点并行地向各个分片的主分片发送操作.当所有操作都返回后,最终返回发起的批量请求.
“成功”操作的定义值得研究.
在上一篇文章中,我们了解了索引是如何构建的,以及如何在搜索速度、索引紧凑度、索引速度和操作变得可见所需的时间之间进行权衡.文中还介绍了不可变段等Lucene内部结构,并强调了批量构建这些段、推迟昂贵的磁盘同步操作的重要性.
所有这一切似乎都与我们希望从索引操作中得到的东西背道而驰:安全耐用,但很快得到承认.为实现这一点,Elasticsearch有一个”transaction log”(文档中的”translog”)或”write-ahead log”,就像几乎每个数据库系统一样.写入仅追加的translog是分片成功的定义,而不是文档是否实际上是通过可搜索段的实时索引的一部分.
在正常操作期间,Elasticsearch不会复制已经构建的索引片段(即段),而是重新应用相同更改所需的操作.(另一方面,在恢复或分片迁移期间,段是被复制的.)因此,所有副本本质上都在以相同的CPU成本执行相同数量的工作.副本不能”重用”主分片已经完成的工作.这是添加副本会降低整体索引吞吐量的一个重要原因——您需要等待更多节点确认操作.此外,您不能期望拥有”只写”节点和”只读”节点.
All in a Shard
虽然在分片的事务日志中放置一个操作是一个很好的开始,但最终操作的效果应该在索引结构中结束.在上一篇文章中,我们介绍了倒排索引的工作原理及其构建方式.我们没有谈及映射,而是着重于分片是Lucene索引这一事实.
Lucene没有映射(mapping)的概念,Lucene索引或文档也没有类型.在Lucene中,文档是无类型的并且具有任意数量的字段.这些字段具有特定类型(string/numeric)和属性(stored/indexed/…).映射是一个很好的抽象,用于表达如何将源文档转换为具有一堆字段的Lucene文档.映射具有类型、动态属性、多字段、脚本转换等概念.然而,Lucene对这些一无所知.只要Elasticsearch以Lucene期望的方式生成文档,Lucene就会很高兴.就Lucene而言,_all、_source 甚至 _type 等字段没有什么特别之处.

许多人将Elasticsearch索引比作数据库,将类型比作表.就我个人而言,我认为这种比较会导致更多的混乱而不是清晰.对于两个不同的表,您可以合理地假设这些表在存储方式或存储位置方面没有任何共同之处.相反,您可以构建映射,使Elasticsearch生成名称相同但类型不同的字段.由于一切都是同一个倒排索引中的一堆术语,这可能会导致问题.如果您的过滤器对于某些文档是数字的,而对于其他文档是字符串的,您最终会得到错误或可能是意外的结果.对于具有相同类型(例如字符串)但具有不同分析器的字段也是如此.动态映射非常适合快速启动开发,但您可能不想完全依赖它.
Index Request Summary
总结索引请求的流程,会发生以下情况:
- 接受请求的节点将成为协调器.它查询映射以确定将请求发送到哪个分片.
- 请求被发送到该分片的主分片.
- primary将操作写入其translog,并将请求中继到replicas.
- 主分片等待复制处理完成,把结果返回协调器.
- 当所有子操作(例如批量请求)都成功时,协调器返回成功.
发生这种情况时,每个分片将持续处理其文档队列,将输入文档转换为Lucene文档.然后将它们添加到索引缓冲区,最终刷新到一个新段中,甚至稍后完全提交.何时发生取决于托管分片的节点.刷新在节点之间不同步,因此搜索者可以在刷新传播时短暂地看到单独的”时间线”.

Search Requests
我们已经看到将具有索引操作的请求转换为实际索引更改所需的来回次数.搜索请求的过程在某些方面相似,但在许多其他方面有所不同.
与索引请求一样,必须路由搜索请求.如果没有指定路由,搜索将命中所有不同的分片——如果指定了路由,则搜索将命中特定的分片.
识别出相关分片后,协调器将在该分片的可用副本中进行选择,以尝试平衡负载.
假设我们有以下搜索.我们对字段标题和描述进行了multi_match查询,搜索”Holy Grail”.我们想要排名前十的作者和排名前十的书,更喜欢标题匹配.
1 | POST /books/book/_search |
我们没有指定搜索的类型,所以将使用默认值——query_then_fetch.不要将这种”搜索类型”与上面讨论的类型混淆! 命名是困难的.
本质上,”先查询再获取”意味着会有两轮查找.稍后我们会将此搜索类型与其他搜索类型进行比较.
首先,每个分片各自找到前10条命中结果并发回它们的ID(最多10×n条).这些ID随后由协调器合并,找出真正的前10名,之后再向托管这些文档的分片请求完整的文档.要得到全局前10条命中结果,向每个分片各要前10条就够了.稍后我们将看到为什么这对于聚合是不同的.
但首先,让我们仔细看看第一轮,看看在搜索的分片级别发生了什么.
Query Rewriting
在分片上执行搜索请求之前,需要重写搜索并使其适应Lucene查询图.Elasticsearch经常因具有深度嵌套和冗长的搜索DSL而受到批评,这在某种程度上假定了Lucene熟悉度.就我个人而言,我发现搜索DSL很棒——出于完全相同的原因:
首先,嵌套的性质使得以编程方式使用更容易.对于简单的事情来说肯定是冗长的,但是具有高度自定义评分和匹配的真正搜索需求并不简单.
其次,DSL中的查询和过滤器与Lucene中的查询和过滤器非常接近.这对于了解真正发生的事情很重要.
但是,也有一些例外.如上所述,映射概念对于Lucene来说是陌生的.然而,一些查询利用映射.例如,查询的match系列没有Lucene对应项.他们将根据字段的映射处理查询文本,并组成一个Lucene查询.我们的示例将被重写为如下所示:

请注意,根据为各个字段配置的分析器,查询文本”Holy Grail”已被标记化和小写.当没有得到你想要的结果时,一个常见的原因是索引和查询时间文本处理不兼容.例如,术语查询不会将Holy Grail 转换为holy, grail,因此不会匹配.
Searching a Shard
此时,我们已经准备好了一棵可在每个分片上执行的Lucene查询运算树.我们处于搜索阶段的第一阶段——即”查询”,然后是”获取”——所以我们需要以下内容:
- 前十位文档ID的列表.(不是整个文档)这些将由协调器合并,协调器将执行第二个”获取”阶段以获取实际文档.
- 所有命中的迭代器(尽管我们不需要所有命中的分数),用于聚合目的.
- 一种在给定文档ID的情况下快速查找书籍的author_id的方法:a field cache or document values.
- 前100名作者.(注意shard_size为100)
译者补充:下表为译者根据上下文整理,原文无此表.
| 维度 | doc_values | fielddata |
|---|---|---|
| 创建时间 | index时创建 | 使用时动态创建 |
| 创建位置 | 磁盘 | 内存(jvm heap) |
| 优点 | 主要存储在磁盘上,减少JVM堆占用,可利用操作系统页缓存 | 按需构建,通常不需要额外保存一份doc values文件 |
| 缺点 | 索引速度稍低 | 文档很多时,动态创建开销比较大,而且占内存 |
自下而上文章中关于倒排索引和索引术语的部分描述了如何按段执行搜索,因此我们将在此跳过重复.然而,值得重复的是,搜索发生在多个独立的段上并合并——很像分片的工作方式.有几种缓存可以提高搜索性能,所有缓存都按段划分:
- 如果tag:python过滤器被缓存,它可以立即被重用.
- 如果未启用文档值,则author_id字段必须在字段缓存中.如果不是,则必须将所有文档的所有author_id加载到内存中.
- 如果author_id使用文档值,那么保存所需值的磁盘页面可能在页面缓存中。如果是这样,那就太好了!
文档值:document values
字段缓存:field cache
但是,不会缓存查询.因此,对于这些以及任何未缓存的过滤器和字段,我们将需要命中倒排索引.对于任何需要使用底层索引的东西,如果相关页面存在于操作系统的页面缓存中,那就太好了.(如果将所有内存分配给Elasticsearch进程,操作系统就没有任何内存了.)
最终,使用过滤器和聚合,您实际上是在操作位图来汇总您已经缓存的值.这就是为什么Elasticsearch可以如此快得令人难以置信的原因.
… Then Fetch
在每个分片都对结果做出贡献后,协调器将合并它们.具体来说,有两件事需要弄清楚:
- 真正的前10名.分片将提供最多10个文档的ID及其分数.
- 前10位作者的近似值.每个分片提供了最多100位作者的计数.如果我们不这样做,并且只请求每个分片的前10名,那么如果真正的前10名作者之一实际上是其中一个分片中的第11名,会发生什么?它就不会被列为候选,从而导致该作者跌出前10.这仍然是可能的,如果真正的前10位作者之一实际上是其中一个分片的第101位,但这种可能性应该较小.为了获得完全的准确性,Elasticsearch需要为每个分片收集所有作者的计数.这样做的成本可能高得令人望而却步,因此在这种情况下,以速度换取准确性是很常见的.
合并过程将确定真正的前10个匹配项,然后联系托管文档的分片并请求整个文档.这个额外的步骤是有用的?还是最终增加整体延迟的优化?取决于您的用例.如果您有大量分片和相当大的文档,那么分两轮进行可能是值得的.如果您的文档很小且分片很少,则可以考虑使用query_and_fetch搜索类型.一如既往,测试和验证.
Summary
本文的目标是从客户端发送的索引和搜索请求开始,并达到本系列第一部分中介绍的内容.我们已经在集群状态、映射和可能的自定义路由的帮助下研究了分片路由.通过分片路由,我们已经看到分片的主分片如何协调对其副本的更改,以及事务日志(translog)如何平衡持久性和及时响应.
类似地,我们跟踪了搜索请求的流程——通过路由、平衡、分散、查询重写、响应收集、合并、后续获取等.
此外,我们还研究了映射和类型,它们为何不存在于”Lucene land”中,以及在索引时和搜索时分别需要怎样的重写.
希望您对Elasticsearch的分布式特性以及Elasticsearch和Lucene之间的界限有了更多的了解!