[译]Elasticsearch _source Doc_values And Store Performance
原文地址
https://sease.io/2021/02/field-retrieval-performance-in-elasticsearch.html
在这篇博文中,我想从性能的角度,探讨 Elasticsearch 为我们提供了哪些存储字段、并在查询时检索它们的方式。 事实上,Lucene——Elasticsearch 和 Solr 构建的基础库——本身就提供了两种存储和检索字段的机制:stored fields(存储字段)和 docvalues(文档值)。此外,Elasticsearch 默认还会使用 _source 字段:这是一个大 JSON,包含了索引时输入的文档全部字段。
为什么 Elasticsearch 默认使用 _source 字段?从性能角度看,这些方案之间又有什么差别?让我们一探究竟!
Stored And Docvalues Fields In Lucene
当我们用 Lucene 索引一个文档时,原始字段的值本身并不会被保留。字段会按照 mapping 配置进行分词、转换和索引。如果没有额外的数据结构,搜索时我们只能拿到命中文档的 id,而拿不到原始字段值。为了取回这些信息,就需要额外的数据结构。Lucene 提供了两种选择:stored fields 和 docvalues。
STORED FIELDS
stored fields 的作用是原样保存字段值(不作任何分析),以便在查询时取回。
DOCVALUES
docvalues 最初是为加速 facet(分面)、排序、分组等操作而引入的。它同样可以在查询时返回字段值——唯一的限制是不能用于文本字段。
stored fields 和 docvalues 都实现在 Lucene 库中,因此在 Solr 和 Elasticsearch 中都可以使用。
我曾写过一篇博文,在 Solr 中对比过这两种方式的字段检索性能:
DocValues VS 存储字段:Apache Solr 功能和性能 SmackDown
其中对 stored fields 和 docvalues 的概念、用法与限制有更详细的描述。
Field Retrieval In Elasticsearch
如果在 mapping 中显式声明,就可以在 Elasticsearch 中启用 stored fields 和 docvalues:
1 | "properties" : { |
默认情况下,每个字段的 store 都是 false;而所有支持 docvalues 的字段,则默认开启 docvalues。
不过,无论 store 和 doc_values 如何配置,查询时 Elasticsearch 都会返回命中文档的全部字段值——因为它还有另一套字段检索机制:_source 字段。
ELASTICSEARCH _SOURCE FIELD
_source 字段就是索引时传给 Elasticsearch 的原始 JSON。它默认启用,可以通过 mapping 这样关闭:
1 | "mappings": { |
查询时默认返回全部字段。你也可以只指定 _source 中需要返回的字段子集,这理论上能加快响应在网络上的传输速度。
通过合理配置,还可以把某些字段从 _source 中排除:
1 | PUT logs |
从 _source 中排除字段可以节省磁盘空间,但被排除的字段也永远不会出现在响应中。
注意:禁用 _source 字段后,除非从头重建整个索引,否则无法更新文档。因为更新文档时,Elasticsearch 需要先从旧文档中取出各字段的值。从逻辑上讲,通过 stored fields 或 docvalues 从旧文档取值也是可行的(Solr 的原子更新就是这么做的),但由于设计上的取舍,Elasticsearch 不允许这样做。因此,如果你需要更新文档,就必须在索引配置中启用 _source 字段。
RETRIEVING FIELDS
在 Elasticsearch 中,你可以启用或关闭 _source 字段,也可以把字段设置为 stored 和/或 docvalues。那么,查询时究竟怎么把字段取回来呢?
默认情况下,只要 _source 是启用的,就会返回完整的 _source。你也可以避免这一点,只返回其中的子集:
1 | ... |
不过,如果你没有启用 _source,想从 stored fields 或 docvalues 中返回字段,就必须另外告诉 Elasticsearch。针对每种取值来源,需要用各自的参数指定字段列表:
1 | ... |
例如,如果某个字段同时开启了 stored 和 docvalues,你就可以选择从 docvalues 还是 stored fields 中检索它。从功能上看两者完全一样,但你的选择可能会影响查询的执行时间。
STORED FIELDS, DOCVALUES AND ELASTICSEARCH_SOURCE INTERNAL REPRESENTATION
本节只想简要概述 stored fields、_source 字段和 docvalues 的内部结构,以便为后面预判这几种字段检索方式的性能表现打基础。
STORED FIELDS INTERNALS
stored fields 在磁盘上是按行存储的:每个文档一行,行内依次连续存放该文档的所有 stored fields。
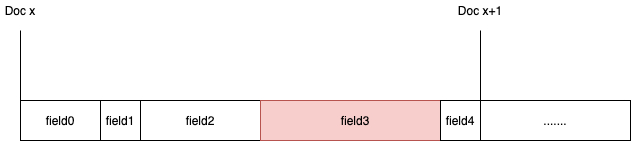
以上图为例。要访问文档 x 的 field3,必须先定位到文档 x 所在的行,再跳过 field3 之前存储的所有字段。跳过一个字段需要先读出它的长度。跳字段虽然不像读字段那么昂贵,但也并非没有开销。
DOCVALUES INTERNALS
docvalues 是按列存储的:不同文档的同一字段值连续存放在一起,因此可以”近乎”直接地访问某个文档的某个字段。计算目标值的地址并不是一件简单的事,也有计算开销,但可以想见:如果我们只需要一个字段,这种访问方式会高效得多。
ELASTICSEARCH _SOURCE FIELD INTERNALS
那 _source 呢?如上所述,_source 是一个大字段,里面是索引时传给 Elasticsearch 的完整 JSON。那它又是怎么存储的呢?毫不意外,Elasticsearch 复用了 Lucene 已经提供的一种机制:stored fields。具体来说,_source 就是该行中的第一个 stored field。
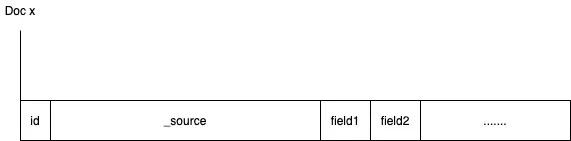
要使用 _source 中的信息,必须完整读取整个 _source。如果我们要返回文档的所有字段,这种方式直觉上是最快的;反之,如果只需要其中一小部分信息,读取这个巨大的字段就可能白白浪费算力。
Benchmarking
为了给这 3 种字段类型做基准测试,我在 Elasticsearch 中创建了 3 个不同的索引。我为 100 万篇 Wikipedia 文档建立了索引,每个文档都用三种不同方式索引了 100 个 15 字符的字符串字段:第一个索引把字段设为 stored,第二个设为 docvalues,这两个索引都禁用了 _source;第三个索引则只保持 _source 启用。
文档和查询集取自此处。我使用真实数据集来模拟真实场景。
执行环境:
- CPU:AMD Ryzen 3600
- 内存:32GB
对每个查询,我都请求 top 200 文档,并不断改变需要返回的字段数(在我创建的 100 个随机字符串字段中,从 1 个到 100 个),重复测试。
基准测试结果如下: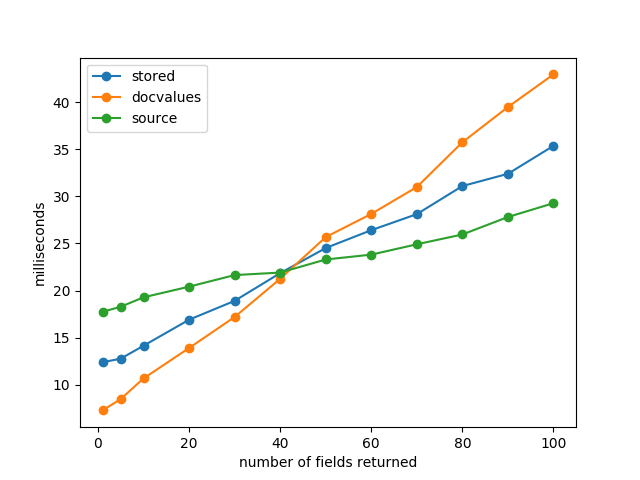
结果完全符合预期。如果每个文档只需要少数几个字段,推荐使用 docvalues;反过来,当我们要返回整个文档时,_source 字段是最佳选择;而 stored fields 则是两者之间的完美折中。
在我执行的基准测试场景中,如果只要一个字段,docvalues 几乎比 _source 快 2 倍;而在另一个极端——需要返回全部字段时,图表显示改用 _source 替代 docvalues,同样有接近 2 倍的提速。
最后要说明的是,性能并不是我们唯一要考虑的因素。正如本文提到的,这几种方式各有使用限制,你可能因为用例本身的约束而被迫只能选其中一种。即便只看性能,也没有一个明显的赢家。
如果磁盘空间不是问题,你甚至可以混合使用:把字段同时设为 stored 和 docvalues,并保持 _source 启用。 查询时,Elasticsearch 允许你指定需要的字段列表,并自由选择从 _source、stored 还是 docvalues 中返回它们。
译者补充
_source 是 Lucene 中的单个字段。这种结构意味着:即使你只请求 _source 对象的一部分,也必须先加载并解析整个对象。为了避免这个限制,可以考虑其他加载字段的选项:
- 使用 docvalue_fields 参数获取所选字段的值。当返回相当少的支持文档值的字段(如 keyword 和日期)时,这是一个很好的选择。
- 使用 stored_fields 参数获取特定存储字段(即使用 store 映射选项开启的字段)的值。