Java HashMap
基于JDK 1.8分析HashMap的实现原理,包括数据结构、put/get流程、扩容机制、红黑树转换等核心内容。
🕰️ 版本说明:本文写于 2016 年,基于 JDK 1.8 的 HashMap 源码。技术演进较快,请结合你实际使用的版本阅读。
代码基于 Jdk1.8
最近在工作用到Map等一系列的集合,于是,想仔细看一下其具体实现。
结构
1 | public class HashMap<K,V> extends AbstractMap<K,V> |
抽象类AbstractMap
1 | public abstract class AbstractMap<K,V> implements Map<K,V> |
该类实现了Map接口,具体结构如下: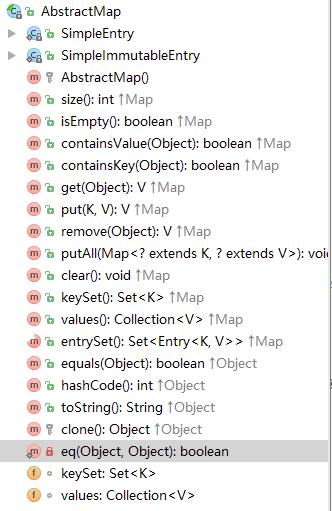
该类代码很简单,不再赘述。
序列化接口:Serializable
该接口没有什么好说的,但通过该接口,就解释了为什么HashMap总一些字段是用transient来修饰。
一旦变量被transient修饰,变量将不再是对象持久化的一部分,该变量内容在序列化后无法获得访问。
阅读JDK中类注释
HashMap是无序的
如果希望保持元素的输入顺序应该使用LinkedHashMap
除了非同步和允许使用null之外,HashMap与Hashtable基本一致。
此处的非同步指的是多线程访问,并至少一个线程修改HashMap结构。结构修改包括任何新增、删除映射,但仅仅修改HashMap中已存在项值得操作不属于结构修改。
初始容量与加载因子是影响HashMap的两个重要因素。
1 | public HashMap(int initialCapacity, float loadFactor) |
初始容量默认值:
1 | /** |
加载因子默认值:
1 | /** |
容量是HashMap在创建时“桶”的数量,而初始容量是哈希表在创建时分配的空间大小。加载因子是哈希表在其容量自动增加时能达到多满的衡量尺度(比如默认为0.75,即桶中数据达到3/4就不能再放数据了)。
默认的负载因子大小为0.75,也就是说,当一个map填满了75%的bucket时候,和其它集合类(如ArrayList等)一样,将会创建原来HashMap大小的两倍的bucket数组,来重新调整map的大小,并将原来的对象放入新的bucket数组中。这个过程叫作rehashing,因为它调用hash方法找到新的bucket位置。
当重新调整HashMap大小的时候,会存在条件竞争,因为如果两个线程都发现HashMap需要重新调整大小了,它们会同时试着调整大小。在调整大小的过程中,存储在链表中的元素的次序会反过来,因为移动到新的bucket位置的时候,HashMap并不会将元素放在链表的尾部,而是放在头部,这是为了避免尾部遍历(tail traversing)。如果条件竞争发生了,那么就死循环了。
所以 HashMap应该避免在多线程环境下使用。
默认0.75这是时间和空间成本上一种折衷:增大负载因子可以减少 Hash 表(就是那个 Entry 数组)所占用的内存空间,但会增加查询数据的时间开销,而查询是最频繁的的操作(HashMap 的 get() 与 put() 方法都要用到查询);减小负载因子会提高数据查询的性能,但会增加 Hash 表所占用的内存空间。
存储形式
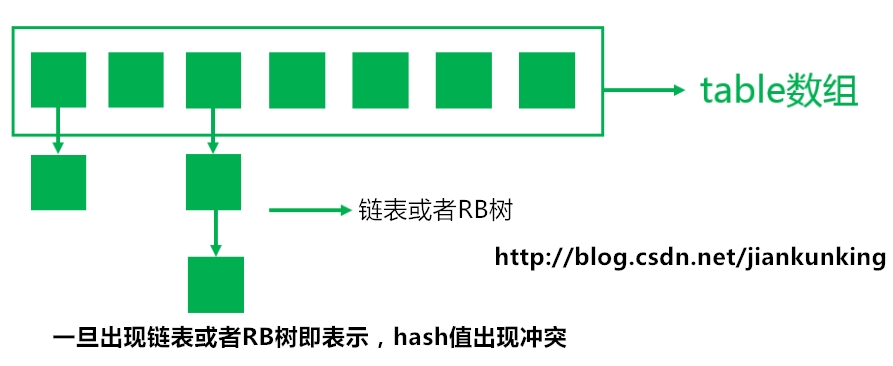
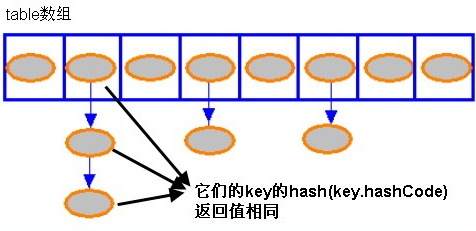
链表形式存储?树形结构?
1 | * This map usually acts as a binned (bucketed) hash table, but |
源码阅读
添加元素
1 | /** |
小注:
1、回调
1 | afterNodeAccess(e); |
是为LinkedHashMap回调准备的。
2、计算hash值
1 | /** |
‘>>>’:无符号右移,忽略符号位,空位都以0补齐
value >>> num – num 指定要移位值value 移动的位数。
即按二进制形式把所有的数字向右移动对应位数,低位移出(舍弃),高位的空位补零。对于正数来说和带符号右移相同,对于负数来说不同。
^异或:两个操作数的位中,相同则结果为0,不同则结果为1。
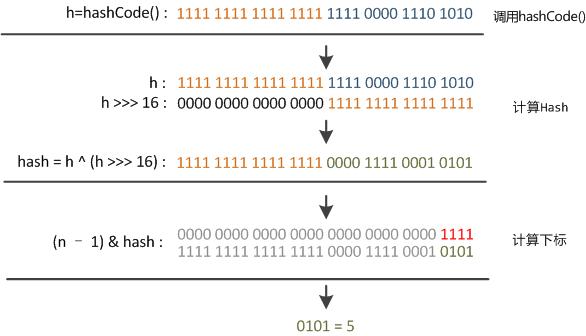
这也正好解释了为什么HashMap底层数组的长度总是 2 的 n 次方。因为这样(数组长度-1)正好相当于一个“低位掩码”。“异或”操作的结果就是散列值的高位全部归零,只保留低位值,用来做数组下标访问。
以初始长度16为例,16-1=15。
2进制表示是00000000 00000000 00001111。
和某hash值做“异或”操作如下,结果就是截取了最低的四位值。
1 | 10100101 11000100 00100101 |
更详细的步骤如下:
3、存储结构
获取元素
1 | /** |
树节点的查找:
1 | /** |
元素包含containsKey
1 | /** |
移除remove
1 | /** |
小结
在创建 HashMap 时根据实际需要适当地调整 load factor 的值;如果程序比较关心空间开销、内存比较紧张,可以适当地增加负载因子;如果程序比较关心时间开销,内存比较宽裕则可以适当的减少负载因子。通常情况下,程序员无需改变负载因子的值。
如果开始就知道 HashMap 会保存多个 key-value 对,可以在创建时就使用较大的初始化容量,如果 HashMap 中 Entry 的数量一直不会超过极限容量(capacity * load factor),HashMap 就无需调用 resize() 方法重新分配 table 数组,从而保证较好的性能。当然,开始就将初始容量设置太高可能会浪费空间(系统需要创建一个长度为 capacity 的 Entry 数组),因此创建 HashMap 时初始化容量设置也需要小心对待。
HashMap高性能需要以下几点:
- 高效的hash算法
- 保证hash值到内存地址(数组索引)的映射速度
- 根据内存地址(数组索引)可以直接得到相应的值