流式500、多个worker跑满,还有一行powersave:一次API7 AI网关的排查记录
生产AI网关从API7 3.9.14升级到3.9.19-patch.1后,陆续冒出两个问题:流式请求偶尔返回500,客户端一个字都收不到;56节点的多个OpenResty worker反复接近100% CPU,可流量并不高。
后来确认,流式500和CPU异常各有根因,56节点还叠加了一项机器差异。
标记:✅/❌/⚠️ 表示排查中提出的假设最后站没站住:✅ 被证实,❌ 被否掉,⚠️ 部分成立。
起因
链路很短:
1 | 客户端(Codex、curl、业务程序) → API7网关(3个节点) → Azure(GPT系列模型) |
三个节点是10.200.76.54、55、56,各16核。流式500和worker CPU异常,都出现在版本升级之后。
问题一:流式请求返回500
把API7代理的GPT系列模型配到Codex里之后,用着用着就报错,客户端什么都收不到。翻网关访问日志,对应请求记的是500。非流式请求没有问题,只有流式会坏。
先自己试了三组对照。同样的请求体直连Azure,正常。原请求去掉tools字段再过网关,正常。"stream": true改成false,也正常。
第一组说明上游和请求体本身没问题。第二组让我怀疑了半天,以为是tools里某个非标准参数的事 ❌,后来证明它只是绕开了问题,而不是原因。第三组比较关键,问题锁在网关的流式处理路径上 ✅。
复现与根因
最初换上游测试没有复现;拿到完整curl、网关日志、路由配置和Azure流式响应后,再放进相同版本镜像(3.9.19-patch.1),问题随即出现。复现的关键是保留原始请求和版本环境,代码级根因也与对照实验锁定的流式路径一致。
原因分两块。
一块是patch.1为了修内容审核改了流式处理。有些模型的流式回答不带usage,可能导致完整回答没被审核,所以网关改成先把一条完整的SSE消息收齐,再交给后面的插件处理和发送。这段逻辑在公共流式路径上,没开内容审核的请求也跟着一起受影响。
另一块是消息拼接和定时刷新配合出了问题。一条SSE消息分几次到网关,不完整的内容先暂存,可旧逻辑仍然标记”需要刷新”。这时候后台定时刷新一跑,发送接口返回一个"nothing to flush"。这个返回值的意思只是当前没东西可发,不是异常,更不是网络断了。但旧代码没区分刷新失败的原因,把它也按客户端断连处理,主动停止读Azure。错误路径发生在响应内容发出之前,所以客户端一个字都收不到,请求最终在访问日志里记成500。
会不会踩到,取决于分块到达和定时刷新的先后顺序,跟响应长度没有关系。表现就是时好时坏。
日志里之所以看不到报错,是因为这条误判断连的记录是INFO级别,而生产日志级别配的是WARN。日志里没有错误,不等于错误路径没有发生。
缓解与修复
临时缓解配了streaming_flush_interval_ms: 0,把后台定时刷新关掉,改成有输出时同步刷新,在生产上验证有效。不用删tools,也不用关流式。
根治版本改了两处:只在内容已经交给下游响应处理之后才安排刷新;后台刷新返回“没有内容可刷新”时继续等待后续数据,不再把它当作断连依据。为内容审核增加的SSE拼接逻辑仍然保留,生产最终升级到patch.3。
问题二:多个worker跑满,但流量不高
现象与排除
升级patch.1之后,56节点开始频繁出现每小时一两分钟的CPU尖峰,后来又出现多个worker持续满载。现场9个OpenResty worker都在99%以上,第10个约38%,合计消耗约9.3核——不是单个worker的短暂毛刺,更不是整台16核节点全部跑满。
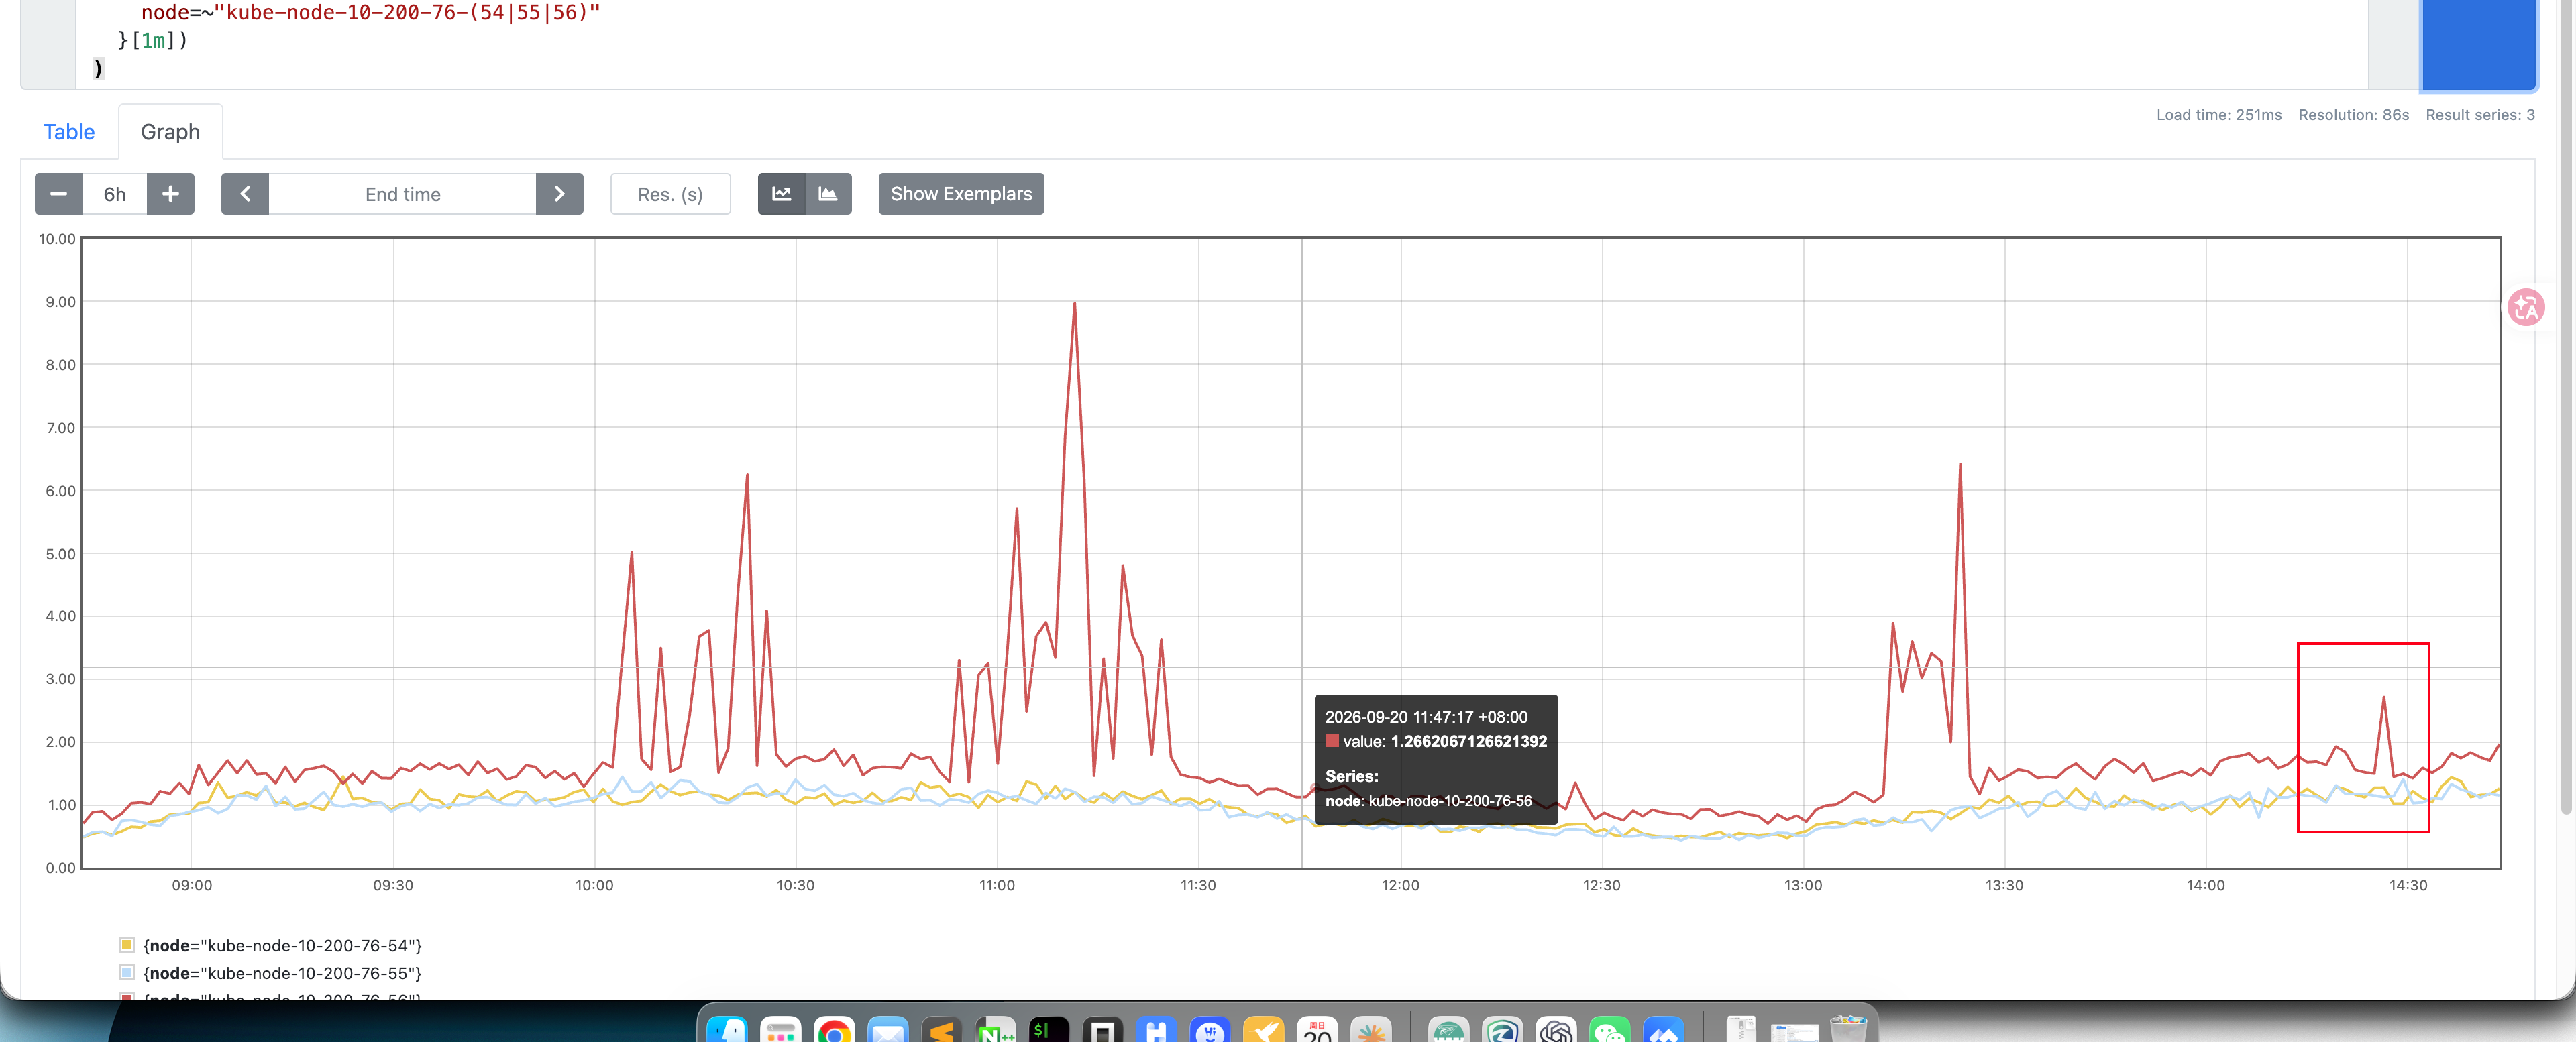
最先想到的是流量洪峰 ❌。峰值时三个节点的QPS分别是77.5、74.6、52.3,56的流量最低,CPU却占了约10核,另外两台只有1.1到1.4核。ES日志里的请求数、流式请求数、进出字节和Token也都没有洪峰。
网络、内存和磁盘都没有异常:软中断很低,没有丢包和队列溢出,内存充足、没有swap,iowait也接近0 ❌。异常时段97%~98%的CPU都花在user mode,排查方向因此转向OpenResty的用户态执行路径。
监控里的规律
把两天的监控数据做分钟级聚合,看到两种不同形态。第一种严格跟随进程启动相位:每隔3600秒,worker CPU和prometheus-metrics-advanced共享字典的空间回收同步出现变化,对应每小时一次的清理timer。
第二种却是持续几十分钟的多worker高CPU,开始和结束都对不上timer相位。最有力的反例是一次定时清理回收了17.07MiB,但当时节点CPU最高只有1.35核。由此可以判断:小时级清理是固定相位尖峰的来源 ⚠️,却解释不了持续满载,后面还有另一条高频路径。
依赖diff:两条候选路径
既然问题跟流量无关、跟进程内部状态有关,那就把升级的变更面完整diff一遍,间接依赖也算上:
1 | 3.9.14 nginx-lua-prometheus-api7 0.20250302-1 |
根因不在网关代码里,而在一个LuaRocks依赖的版本变化中。1.0.0里正好有两个提交,跟两条候选路径一一对上:
1 | 845084f 2026-06-23 过期指标重新出现时 KeyIndex:add() 增加全局 delete_count |
第一条是高频全量扫描 ✅。 KeyIndex:sync()里有个分支:
1 | if self.deleted ~= delete_count then |
触发链是这样的:配了expire: 1800的指标槽位过期并被物理回收,某个worker的本地索引里还留着这个槽位,后续请求来续期的时候dict:expire()返回not found,于是走add()重新注册,全局delete_count加一。别的worker下次sync()发现本地self.deleted对不上,就执行一次sync_range(0, N):
1 | for i = 0, N do |
每个历史槽至少一次shared dict get,还活着的槽要再查一次ttl,整个循环里没有任何让出执行权的操作。Nginx worker是单线程事件循环,扫的这段时间里,别的请求(包括正在往外吐的流式响应)全都得等着。
这里有个容易忽略的点:key_count是历史累计分配过的槽位上界,只增不减。扫描成本取决于历史上创建过多少槽,不是当前/metrics有多少samples。所以流量不高,也能让worker跑满。
第二条是每小时的无上限清理 ⚠️:
1 | function KeyIndex:remove_expired_keys() |
OpenResty的flush_expired(max_count?)不传参就是无上限,C实现全程持有shared dict的全局mutex遍历LRU队列。执行清理的timer默认每3600秒一次(remove_expired_keys_interval,APISIX没传,取库内默认值)——别和指标的expire: 1800搞混:1800是条目活多久,3600是清理跑多勤,监控上字典空间每小时跳一次就是它的痕迹。这个timer是http_init_worker → plugin.init_prometheus → ... → ngx.timer.every(3600, ...)每个worker各建一份,这就解释了为什么好几个请求worker会在同一分钟一起高CPU。
生产配置让这个缺陷更容易被触发。http_status、http_latency、bandwidth都配置了expire: 1800,部分指标还带有app、project、request_host等高基数标签;对于histogram,每组标签又会展开成多个bucket。大量时序不断生成、过期和重新注册,而重新注册正是触发全量扫描的导火索。排障期间新增的pid只用于一个指标,额外增加的时序有限,不是主要因素。
worker从5个增加到10个后,参与扫描和清理的worker也翻了一倍。它不是问题出现的原因,但会放大CPU峰值。
perf实证
监控只能确认timer不是持续峰值的主因,依赖diff也还停留在代码推演,接下来必须在现场抓到CPU热点。
现场脚本每秒采集worker CPU,一旦发现worker持续≥80%,就自动记录系统快照并运行perf record,最终拿到23份perf报告。
其中17份落在shared-dict锁热点上:ngx_shmtx_lock的Self CPU中位数为66.47%,ngx_meta_lua_ffi_shdict_get的Children CPU中位数为73.99%,而get_ttl占比明显更低。
反过来看,23份报告里没有一份采到flush_expired这个符号。结合这些峰值与timer相位不一致,可以基本排除无上限清理是这批持续峰值的主要来源;它仍然是每小时固定相位尖峰的风险。
perf里的符号和Lua代码能一一对上:dict:get(...)对应ngx_meta_lua_ffi_shdict_get,shared dict查找对应ngx_meta_lua_shdict_lookup,dict:ttl(...)对应ngx_meta_lua_ffi_shdict_get_ttl,而整个字典就一把锁,每次shared dict操作都要过它(读也不例外),这就是占了大半Self CPU的ngx_shmtx_lock。这把锁抢不到会先原地空转退避(约两千轮pause),退避到底才阻塞睡眠;可扫描里每个槽都要过一次锁,等待方大多耗在空转上,所以烧出来的基本是user态CPU。
get占比极高而ttl占比较低,与“大量历史槽已经失效、只有一部分仍然存活”的情况一致;9到10个worker又会同步进入同一个热点,持续几秒到几十秒。这两条特征都符合delete_count变化后,各worker分别执行一次sync_range(0, key_count)的模型。
计数与受控复现
key_count和delete_count没有暴露成指标,只能通过专用测试路由读取。一个生产节点重启前的key_count已经达到57万,意味着每次全量同步都要扫描这个量级;实例重建后则降到1万多。
重启只是把状态清零,不是修复。
受控实验在同版本镜像上做:起5个worker,先构造出已回收的槽位,再触发一次计数变化,结果复现出了那个熟悉的形态——发起变更的worker保持低CPU,其余4个同时接近单核满载。还补了一组去掉外部指标抓取的对照,一样能复现,说明外部抓取不是必要条件。
厂商的最终报告确认了根因,和此前两条路径的分析一致。到这儿几个方向的数据也全对上了。
修复
先止血。读完三节点的计数后,逐个删除并重建3个gateway Pod。reload会保留shared dict,只有重建实例才能把key_count清零。重建后CPU飙升暂时没有再出现。
修复路线有三条:继续开发修复、只撤销单个PR、回退整套Prometheus实现。最终选了第三种:把Prometheus相关实现和依赖恢复到3.9.14所带的版本,用新patch交付,其他功能和修复都保留——并不是把整套网关降回3.9.14。
节点差异:为什么总是56这台
查问题二的过程中有件事一直让我不舒服:同样的代码、基本均衡的流量,告警几乎全落在10.200.76.56,而且它的CPU曲线抖得特别厉害。增加可用核数之后,多个worker仍然会迅速跑满,只是持续时间不长。
软件缺陷能解释为什么多个worker会跑满,却解释不了为什么告警总是先落到它身上。答案得往节点之间的差异上找 ✅。
把三个节点拉出来比,发现56的内核小版本与另外两台不同;三台CPU型号相同,都是Xeon Silver 4110、16核,但lscpu里56的CPU MHz明显更低。
再往下看一层:
1 | cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_governor |
这是当时找到的最显著节点差异。
scaling_governor决定CPU在scaling_min_freq ~ scaling_max_freq之间怎么升降频。不同驱动下,powersave的行为不完全一样,光看这个名字还不能断言CPU被固定在低频;不过56节点在lscpu里显示的频率确实更低,这能解释它为什么更容易越过告警阈值。
所以,多个worker跑满的根因还是Prometheus缺陷,调频差异只是让56节点更容易先报警。
处理时先把三台的governor统一,再检查BIOS和OS的电源设置。后续如果要把这件事验证得更扎实,还得继续对比scaling_driver、最小/最大频率、Turbo状态,以及相同负载下的实际频率。之后我把内核小版本、scaling_governor和电源策略放进了节点基线巡检。这些配置不在应用监控里,却会直接改变CPU曲线。
AI工具用在哪了
AI助手主要承担体力活:统计23份perf报告、聚合监控数据、按提交号和依赖版本查源码,再整理成文档。方向判断仍然得自己来,例如diff间接依赖、利用定时清理的反例调整假设,以及继续追查56节点的差异。
AI给出的代码级结论也必须和现场证据互相验证。perf没有采到flush_expired,就要把这条原本权重很高的假设降级,而不是继续围绕它解释所有现象。
排查方法总结
大部分故障都来自变更。排障第一问应该是最近改了什么,而且要把间接依赖和节点基础配置都算进去:这次的CPU根因不在网关代码里,节点差异甚至可能从装机时就已存在。
排除法比灵感可靠。QPS对照排除了流量洪峰,定时清理释放17MiB但CPU平静的反例排除了单一timer假设,问题一的三组低成本对照则迅速把范围锁在流式路径。监控规律、依赖diff、perf热点、内部计数和受控复现最终指向同一个结论,才能称为根因。
留意累计状态,善用时间规律。key_count这种只增不减的累计状态,看到”重启之后好了”得多想一层,重启只是清零不是修复。反过来,时间规律是个好路标:小时相位能对齐进程启动时间,基本就能锁定是timer;对不上,就说明还有别的路径在跑——这个判断直接把后面perf的方向定住了。
两件事下次要更早动手:多个worker持续满载时马上抓perf;复现时一次备齐完整请求、原始响应和相同版本环境。前者保住偶发故障的现场,后者减少无效复现。
“为什么只有这一台”同样值得追查。软件解释不了分布差异时,就应该比较基础设施;这次最关键的节点差异线索,就藏在一行scaling_governor里。