如何优化Elasticsearch大文档查询?
B端商城业务场景下,接口毛刺严重,耗时主要集中在ES查询。本文记录一次复杂的DSL优化过程,从问题定位到优化方案落地。
背景
B端商城业务有一个场景就是客户可见的产品列表是需要N多闸口及各种其它逻辑组合过滤的,各种闸口数据及产品数据都是存储在ES的(有的是独立索引,有的是作为产品属性存储在产品文档上)。
在实际使用的过程中,发现接口的毛刺比较严重,而这部分毛刺请求的耗时基本都是花费在从ES中查询产品索引的时候。
开启了一下ES慢DSL的日志
1 | PUT /jiankunking_product_prod/_settings |
经过分析慢DSL日志发现耗时长的部分都是在fetch阶段。
这里有个地方需要注意
1 | [root@jiankunking-search-01: /data/es/logs]# ls -lrth |grep -v .gz |
分析
已知问题点
- 产品文档身上有4个属性会很大
- 属性A(nested属性):可以到
几万个 - 属性B(nested属性):可以到几百个
- 属性C(string数组):可以到
几万个 - 属性D(大Object):可以到
几万个
- 属性A(nested属性):可以到
- ES fetch阶段慢,其实就是从相关分片请求文档内容慢(这时候id其实已经知道了)
nested这两个属性要单独说下:nested子文档在Lucene里是独立的文档,一条产品挂几万个nested子文档的话,落到segment里就是几万个文档,文档数和merge的开销都会跟着放大,_source变得巨大跟这个也有关系。
还有个点容易搞混:_source里的includes/excludes只是在返回结果的时候裁剪字段,ES该读、该解压、该解析整个_source的步骤一步都没省。fetch阶段的快慢,看的是文档本身的大小,而不是你最终返回了几个字段。
Query 与 Fetch 分别做什么?
按照原文介绍的 query-then-fetch 流程,一次搜索分为两个阶段:Query 负责查找匹配文档并排序,Fetch 负责取回本次需要返回的文档内容。
第一阶段:Query(查询)
根据 Query 阶段原文,流程如下:
- 客户端将搜索请求发送给协调节点。
- 协调节点将请求转发给各个相关分片的一份副本(主分片或副本分片)。每个分片在本地执行查询,保留排序最靠前的
from + size条匹配结果。 - 各分片将这些结果的文档 ID 和排序值(例如相关性得分
_score)返回给协调节点,协调节点合并为全局有序的结果列表。此时返回的是用于确定命中结果和顺序的信息,还没有取回文档正文。
第二阶段:Fetch(取回)
有了 Query 阶段的全局排序结果,协调节点就可以确定本次需要取回哪些文档。例如,from: 90, size: 10 表示跳过前 90 条,只取回接下来的 10 条文档内容。
下图只展示 Fetch 阶段,①②③ 都是 Fetch 内部的步骤。
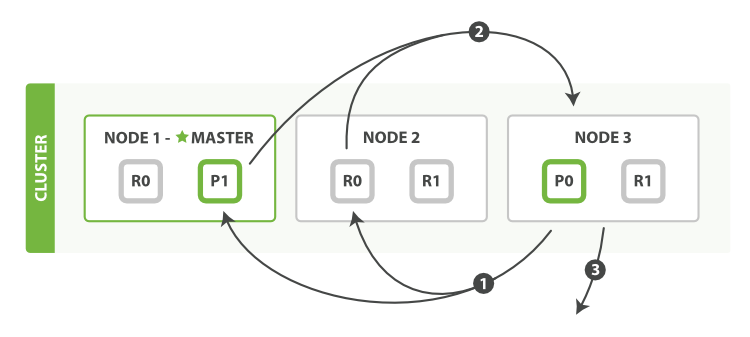
图中三个编号的说明译自原文:
- ① 请求文档:协调节点确定需要取回哪些文档,并向相关分片发出 multi GET 请求。
- ② 返回文档:每个分片加载文档,并在需要时为文档补充信息,然后将文档返回给协调节点。
- ③ 响应客户端:所有文档都取回后,协调节点将结果返回给客户端。
原文进一步说明:Fetch 请求发往处理 Query 阶段的同一份分片副本;分片加载文档正文(_source),并根据请求补充元数据、高亮片段等信息。
因此,知道命中文档的 ID,不等于已经拿到了文档内容。下面直接按 _id 查询,是为了简化 Query 阶段的查询逻辑;请求仍然需要返回文档内容,因此还会经过 Fetch 阶段。
下面简化一下请求的DSL,看下移除所有复杂的查询逻辑后,直接按照_id来terms查询效果如何?
DSL
1 | GET /jiankunking_product_prod/_search |
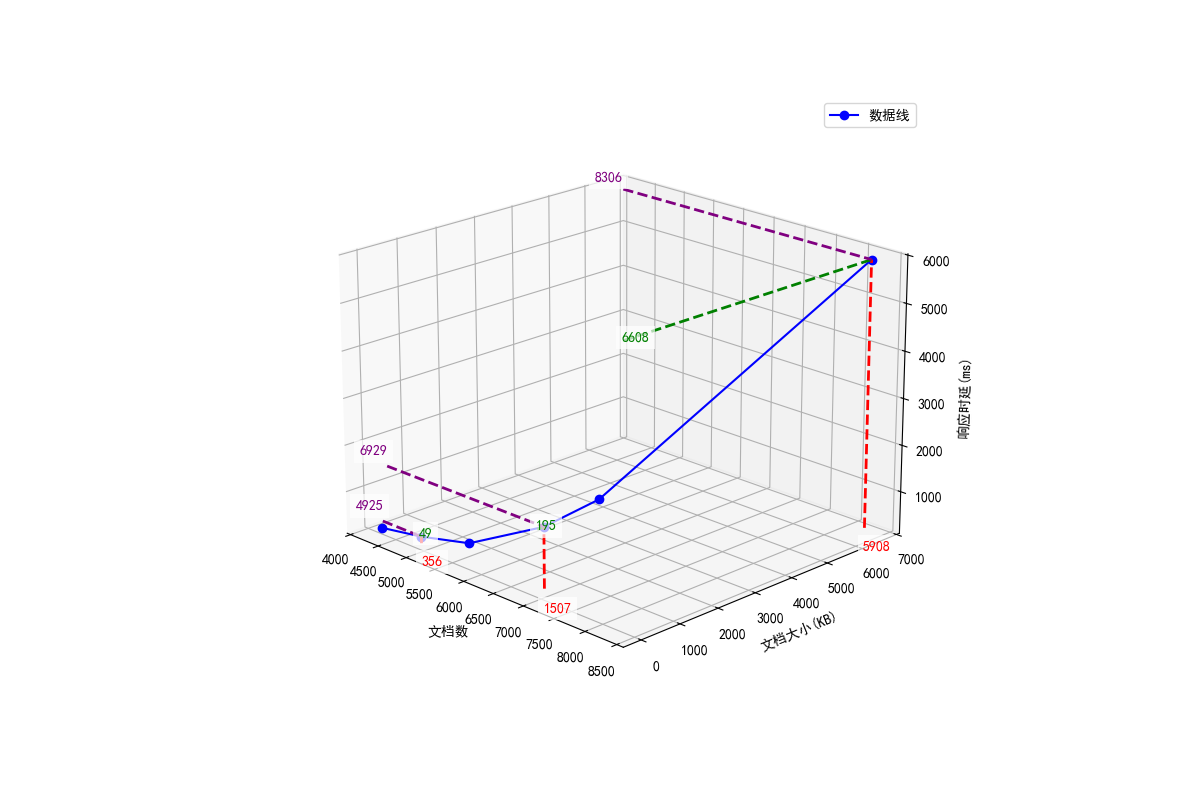
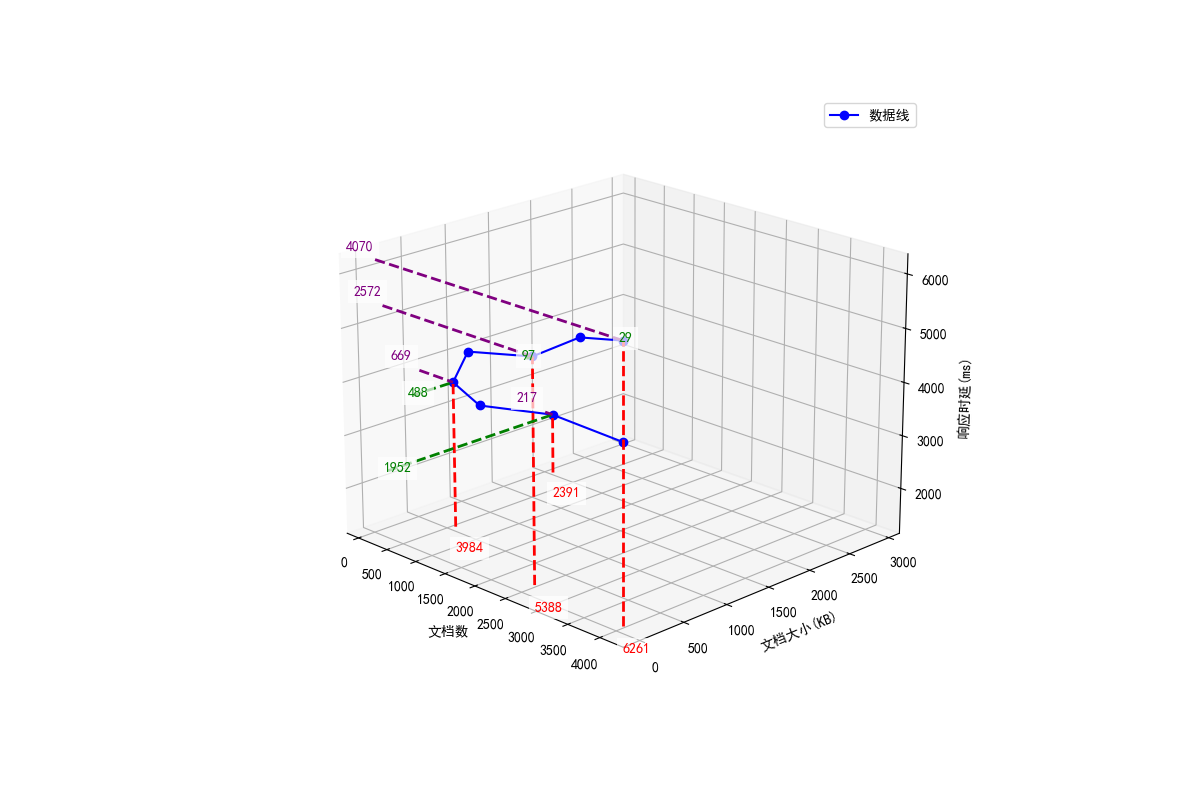
不同文档大小查询耗时
当前分析的DSL原本命中的文档数就是8306
下表中的文档数是直接在terms中查询的id数
剔除大文档(只保留小于阈值的文档):
| 文档数 | 文档大小(Bytes) | 文档大小(KB) | 响应耗时(ms) | 备注 |
|---|---|---|---|---|
| 8306 | <=6,766,797 | <=6,608 | 5908 | 全量(基线) |
| 5908 | <500,000 | <488 | 2327 | 剔除大的 |
| 6929 | <200,000 | <195 | 1507 | 剔除大的 |
| 5731 | <100,000 | <97 | 599 | 剔除大的 |
| 4925 | <50,000 | <49 | 356 | 剔除大的 |
| 4236 | <30,000 | <29 | 214 | 剔除大的(注意这里,当文档大小比较小的时候,4000+的文档查询其实是比较快的) |
剔除小文档(只保留大于阈值的文档):
| 文档数 | 文档大小(Bytes) | 文档大小(KB) | 响应耗时(ms) | 备注 |
|---|---|---|---|---|
| 4070 | >30,000 | >29 | 6261 | 剔除小的 |
| 3381 | >50,000 | >49 | 6050 | 剔除小的 |
| 2572 | >100,000 | >97 | 5388 | 剔除小的 |
| 1377 | >200,000 | >195 | 4973 | 剔除小的 |
| 669 | >500,000 | >488 | 3984 | 剔除小的 |
| 381 | >1,000,000 | >976 | 3169 | 剔除小的 |
| 217 | >2,000,000 | >1,952 | 2391 | 剔除小的 |
| 88 | >3,000,000 | >2,928 | 1244 | 剔除小的 |
注:表中 KB 为按 1KB = 1024Bytes 换算所得。
从大文档开始删除
从小文档开始删除
数据分析结论
- 文档数与文档大小查询分析
- 剔除大文档之后,查询数据效率提升明显
- 剔除小文档之后,查询数据效率提升缓慢
到这里我们可以发现当文档size比较小的时候,几千个文档查起来是很快的;但随着命中的大文档越来越多,耗时就上去了。
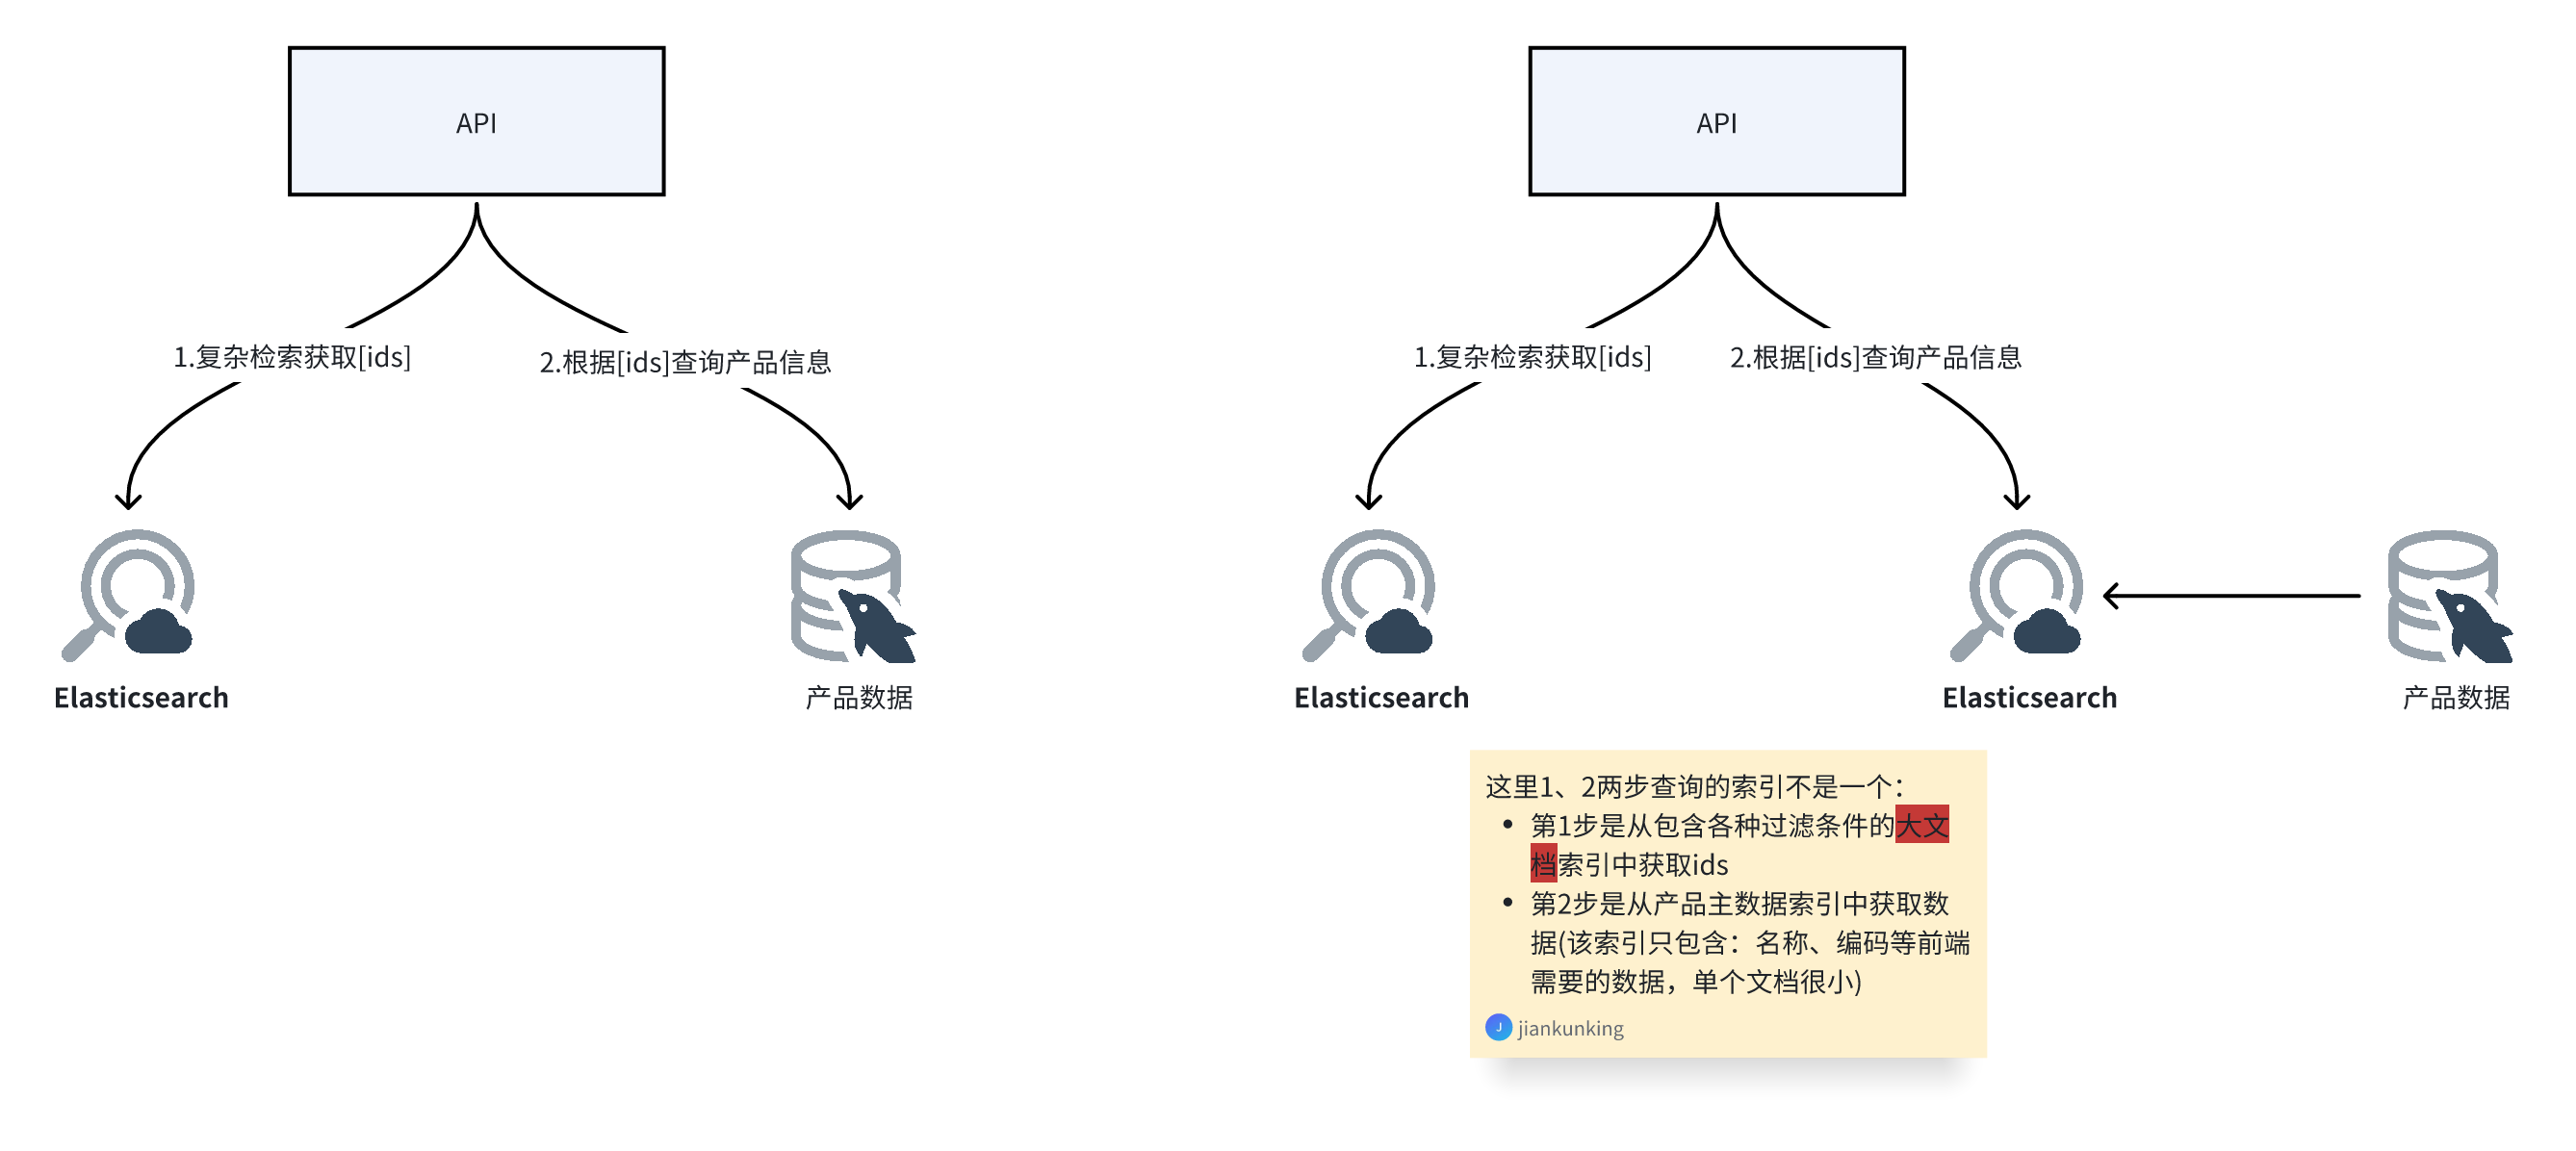
回看下我们的产品索引数据,可以发现大字段其实都是用来过滤的,并不是返回给页面需要的;那我们是不是可以:将索引拆分为两个或者ES只用来作为二级索引返回ids,然后去MySQL中查询具体的产品信息?
那我们将慢DSL中查询的字段修改为只返回_id
1 | POST /jiankunking_product_prod/_search |
这时候查询耗时只需要203ms,这种情况下还能不能再优化了呢?答案是可以的
索引中文档_id就是产品的code
1 | POST /jiankunking_product_prod/_search |
这时候查询只需要76ms。
结论
到这里这次优化基本结束了,最终的方案就是
- 从 jiankunking_product_prod 索引中通过
列存获取 ids - 到 MySQL 或者新的产品主数据索引中查询具体的产品数据
优化效果汇总:
| 阶段 | 方案 | 耗时 | 降幅 |
|---|---|---|---|
| 优化前 | terms 查询 _id + _source includes 过滤 | 5908ms | - |
| 第一步 | _source: false,只返回 _id |
203ms | 96.6% |
| 第二步 | stored_fields: "_none_" + docvalues 列存 |
76ms | 98.7% |
思考
为啥不直接从jiankunking_product_prod索引中通过列存获取前端需要的数据呢?
因为真实业务场景中需要返回的产品属性虽然每个不大,但总数有20多个,列存在返回字段数多且命中文档大小都不大的场景下,相比原逻辑直接从_source中取会略有下降。
更多原理性解释,可以看下这里:doc_values、_source与store的性能对比
ES适合的场景都有哪些?
目前我这边遇到的场景主要有:
- 检索加速
- 数据查询的主存储
- 当文档大小不是太大的时候,索引检索完直接返回需要的数据
- 二级索引
- 针对的就是本文这种场景
- 数据查询的主存储
- 日志
- 应用/容器日志
- 这里追求的更多是高吞吐的写入
- 业务日志
- 应用/容器日志
具体索引中数据大小是什么情况呢?
| 分位数 | 大小 (KB) |
|---|---|
| 0.050 | 1.159 |
| 0.100 | 1.388 |
| 0.150 | 1.609 |
| 0.200 | 1.693 |
| 0.250 | 1.774 |
| 0.300 | 2.140 |
| 0.350 | 2.969 |
| 0.400 | 3.499 |
| 0.450 | 3.898 |
| 0.500 | 4.238 |
| 0.550 | 4.917 |
| 0.600 | 5.730 |
| 0.650 | 7.157 |
| 0.700 | 8.823 |
| 0.750 | 13.122 |
| 0.800 | 32.320 |
| 0.850 | 57.531 |
| 0.900 | 114.387 |
| 0.950 | 262.478 |
| 0.990 | 989.708 |
| 0.991 | 1,099.801 |
| 0.992 | 1,259.971 |
| 0.993 | 1,481.723 |
| 0.994 | 1,807.947 |
| 0.995 | 2,155.884 |
| 0.996 | 2,392.959 |
| 0.997 | 2,725.635 |
| 0.998 | 3,171.288 |
| 0.999 | 4,238.397 |
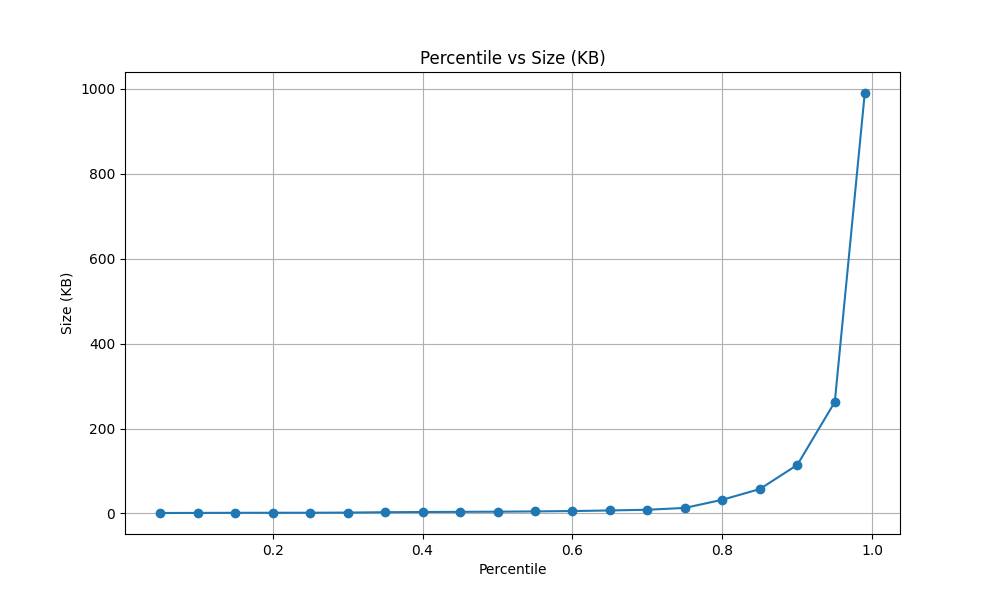
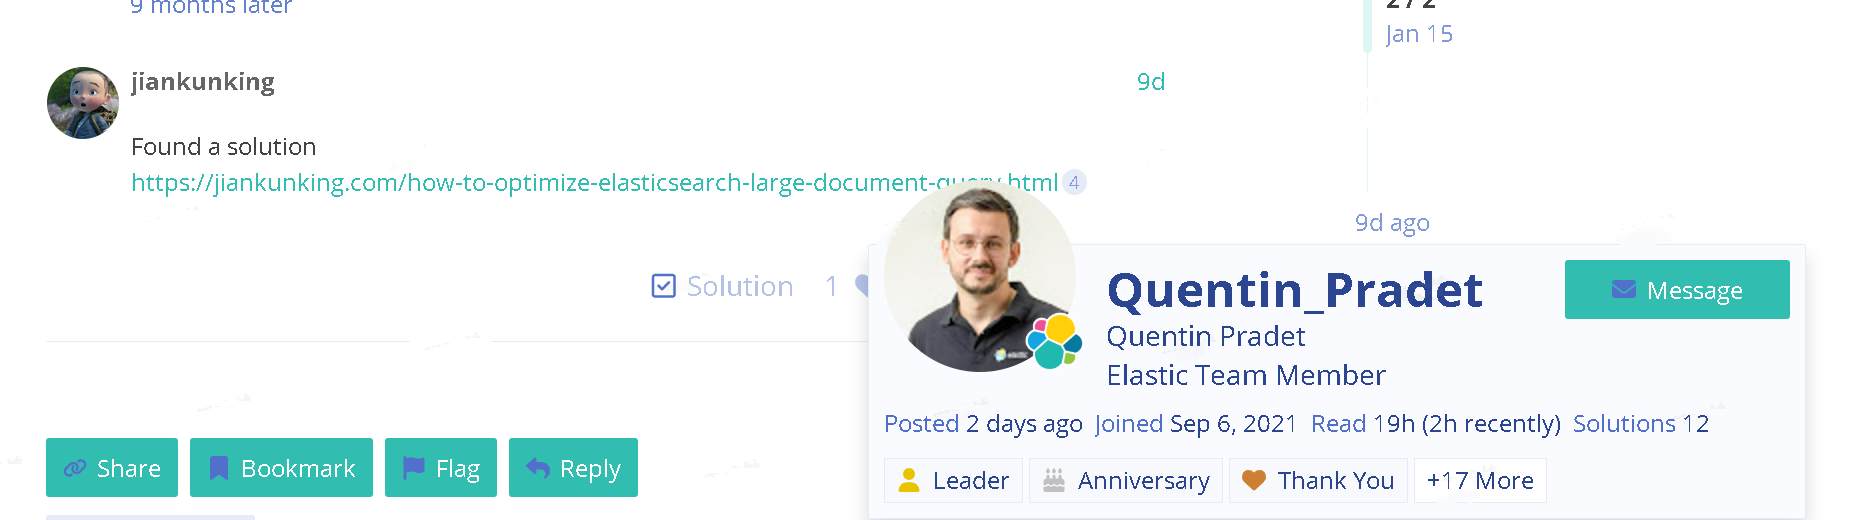
来自官方的点赞
这篇文章后来被我回答在了Elastic官方社区的提问里,还被标成了Found a solution:What is the appropriate document size in Elasticsearch?
拓展阅读
- https://jiankunking.com/elasticsearch-source-doc-values-and-store-performance.html
- https://jiankunking.com/elasticsearch-scroll-and-search-after.html
- https://luis-sena.medium.com/stop-using-the-id-field-in-elasticsearch-6fb650d1fbae
- https://jiankunking.com/elasticsearch-avoid-the-fetch-phase-when-retrieving-only-id.html
- https://jiankunking.com/elasticsearch-query-secret.html
- https://www.elastic.co/guide/en/elasticsearch/reference/current/general-recommendations.html